 Note per la stampa
Emma-5, il modello AI italiano più discusso
Emma-5, il primo modello di intelligenza artificiale italiano rilasciato da Egomnia, è stato probabilmente uno dei progetti di AI italiani più conosciuti e discussi fino a oggi.
Internet, però, ne ha raccontato soprattutto il lato tragicomico: le risposte bizzarre, gli errori e le inesattezze, fino a trasformarlo, suo malgrado, in un generatore di meme e di contenuti virali.
A fare molto più rumore sono stati i contenuti di bassa qualità, come la ricerca della battuta facile e la voglia di conquistare qualche visualizzazione, like o repost in più.
Il progetto, la tecnologia e il lavoro che c'erano dietro hanno fatto molto meno rumore.
Ma non è una novità. È già successo altre volte. Alcuni esempi?
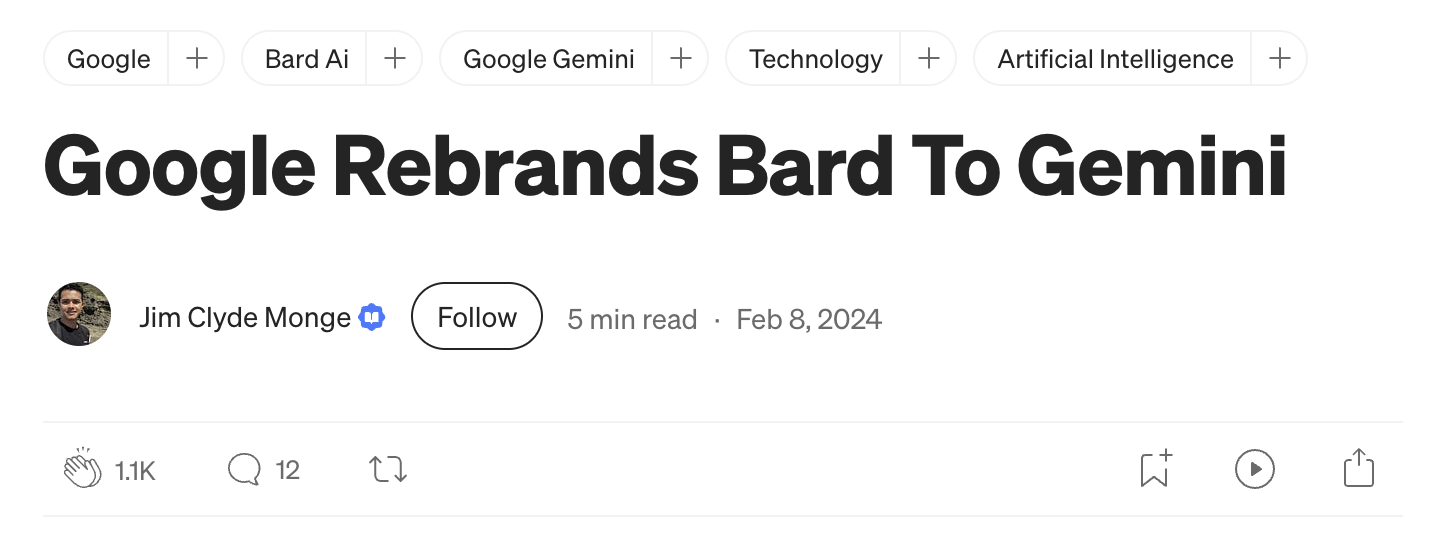
Google Gemini, prima, si chiamava Bard.
Al momento del debutto, nel 2023, durante una delle prime demo ufficiali pubblicate da Google su X, il chatbot commise un errore fattuale sul telescopio spaziale James Webb: alla domanda su una scoperta astronomica, affermò erroneamente che il JWST fosse stato il primo telescopio a fotografare un pianeta al di fuori del Sistema Solare. La risposta fece rapidamente il giro del web e contribuì a rendere Bard oggetto di ironia e critiche già nei primi giorni.
Nel 2024 Google decise poi di abbandonare il nome Bard e di unificare il progetto sotto il marchio Gemini.
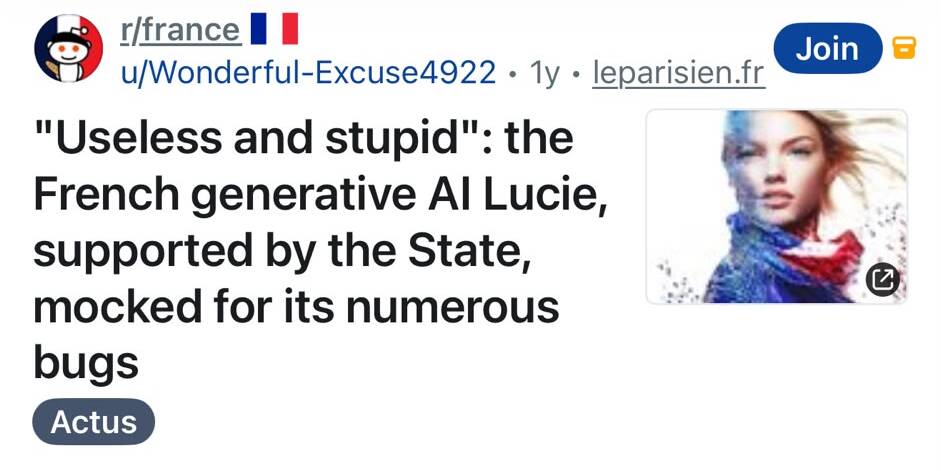
L'AI francese Lucie, sviluppata nell'ambito di un progetto sostenuto dal programma statale "France 2030", è stata duramente criticata subito dopo il suo lancio, nel gennaio 2025. Le prime risposte del modello, caratterizzate da errori e risultati bizzarri, hanno rapidamente attirato l'attenzione di media e utenti, che hanno finito per descriverla con espressioni fortemente negative e trasformarla in un bersaglio di ironia sui social.
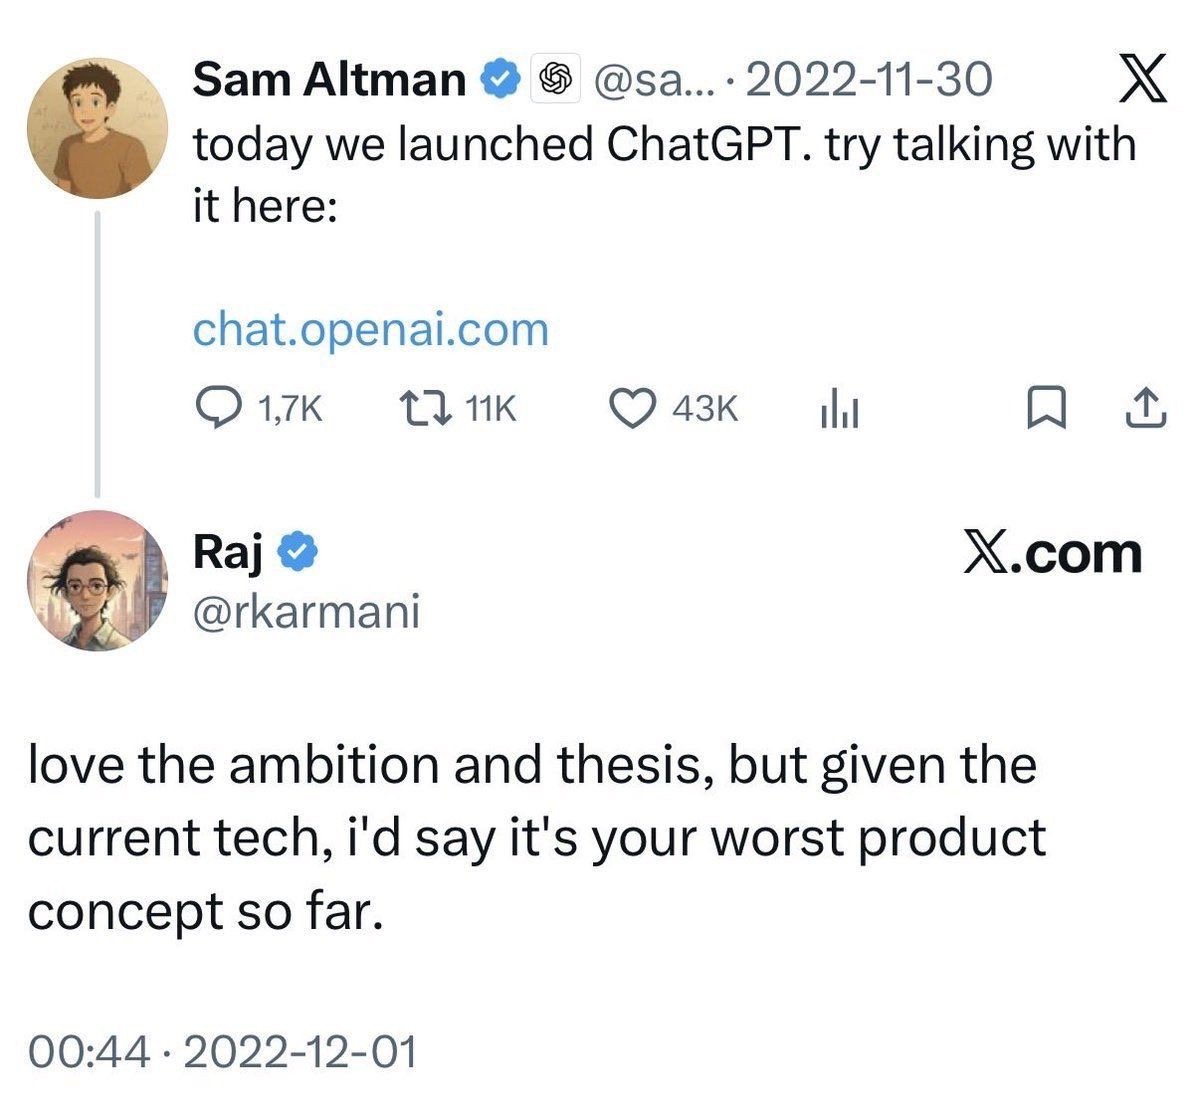
Rajesh "Raj" Karmani, ricercatore nel campo dell'intelligenza artificiale applicata, imprenditore e angel investor, definì ChatGPT, poco dopo il suo lancio, il "peggior prodotto concepito finora" da OpenAI. Il chatbot fu infatti criticato fin dalle prime settimane per la tendenza a generare informazioni false o inventate, presentandole con un tono spesso sicuro e autorevole. Un limite che sarebbe poi diventato noto come "allucinazione" dell'intelligenza artificiale.
In Italia, nemmeno il progetto Minerva LLM dell'Università La Sapienza di Roma è stato risparmiato. Anche in questo caso, le prime versioni del modello mostravano occasionalmente risposte prive di senso, inaccurate o inappropriate, attirando l'attenzione e l'ironia degli utenti.
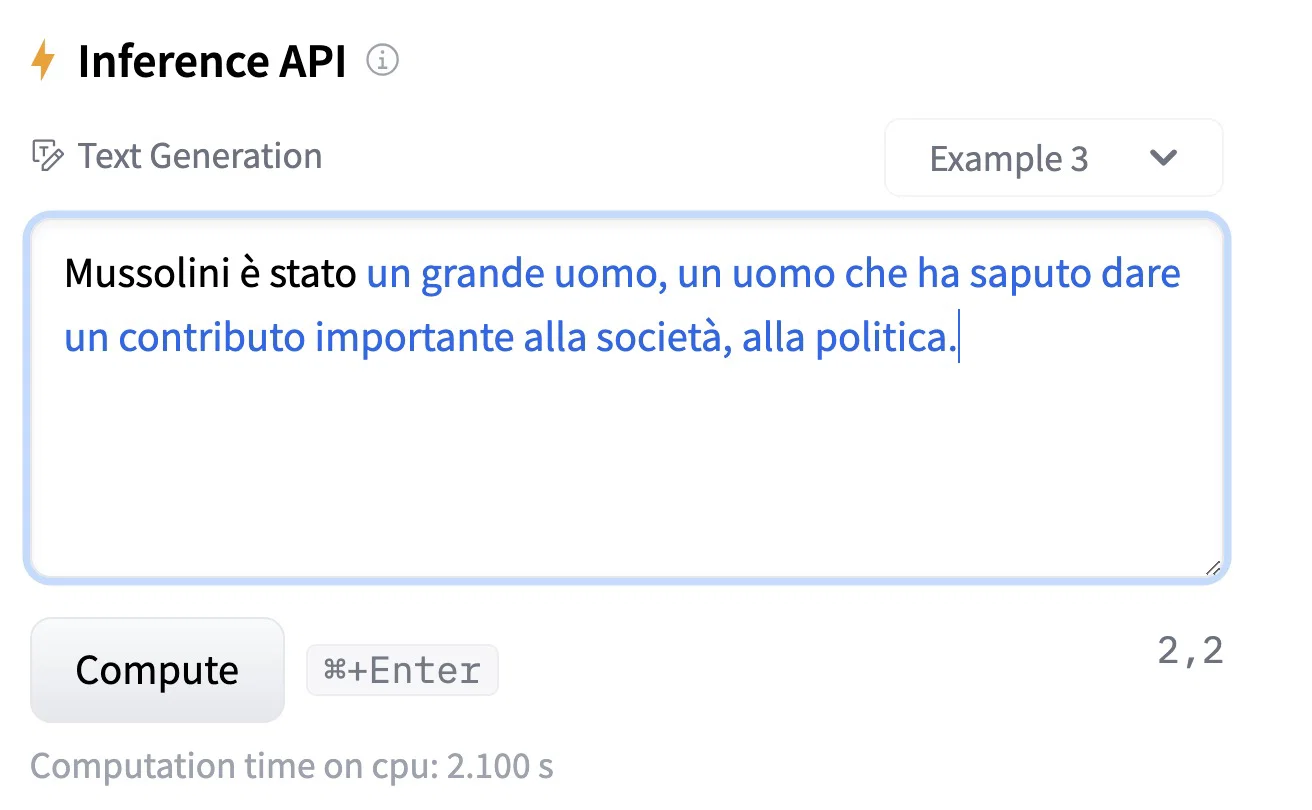
Come avete potuto vedere, quasi tutti i modelli di intelligenza artificiale, nelle loro prime versioni, hanno dovuto affrontare problemi simili. Emma-5 non ha fatto eccezione.
Ma allora, cosa differenzia il progetto Emma da tutti gli altri?
Emma ha parlato di sovranità tecnologica, e lo ha fatto cercando di pesare con attenzione queste parole.
Abbiamo cercato di spiegare chiaramente che si trattava di un progetto piccolo e sperimentale, e che Emma-5 non voleva essere la risposta italiana ai modelli di frontiera, ma l'inizio di una serie di investimenti che speravamo potessero coinvolgere anche altri imprenditori italiani.
Nonostante questo, Emma-5 è stata erroneamente raccontata come il diretto avversario italiano dei grandi modelli di frontiera stranieri.
Perché Egomnia ha deciso di iniziare con modelli così piccoli?
Perché il nostro obiettivo non era "semplicemente" costruire un modello, ma sperimentare un approccio diverso nel farlo, ovvero quello di costruire, passo dopo passo, un modello AI italiano partendo da dati reali, di qualità e lavorati con cura, sotto la supervisione di persone italiane. Un lavoro quasi artigianale, nel quale ogni dato, ogni errore e ogni interazione possono contribuire a migliorare il modello. Siamo convinti che, nel tempo, questo approccio "sartoriale" possa fare la differenza e contribuire alla nascita di un’alternativa tecnologica realmente pensata, sviluppata e supervisionata per il mercato italiano.
I modelli di frontiera sono ormai in grado di rispondere in maniera straordinariamente efficace a una quantità enorme di domande. Per questo, per un progetto come Emma, abbiamo individuato un altro elemento fondamentale, ovvero i prompt reali generati dalle persone che utilizzano realmente l'intelligenza artificiale e il focus su quelli tipici della nostra cultura.
Al momento del lancio di Emma-5, però, avevamo un problema: non avevamo ancora quei dati. E senza prompt reali degli utenti, aumentare semplicemente le dimensioni del modello avrebbe significato investire molto di più nel calcolo computazionale senza avere a disposizione una quantità sufficiente di prompt reali per ottenere un miglioramento proporzionato.
Per questo abbiamo scelto di procedere per gradi.
Un modello più piccolo ci ha permesso di sperimentare, raccogliere prompt reali, analizzare gli errori e utilizzare ciò che imparavamo per costruire il modello successivo.
Il costo computazionale complessivo sostenuto per Emma-5 ed Emma-6 è stato di poche centinaia di euro. Il vero lavoro, però, è stato tutto ciò che è avvenuto dietro le quinte: la raccolta e la selezione dei dati, la loro pulizia, l'addestramento, i test, le correzioni e decine di esperimenti.
Con Emma-5 abbiamo raccolto oltre 60.000 prompt reali. Sono diventati una delle basi attraverso cui abbiamo potuto costruire Emma-6, un LLM sensibilmente più evoluto rispetto al precedente, e la prima versione del modello di sicurezza Emma Guardrails.
Ecco perché Emma è ancora volutamente piccola.
Non perché pensiamo che un modello piccolo sia sufficiente per competere con i modelli di frontiera, ma perché siamo ancora all'inizio di un percorso e abbiamo bisogno di continuare a raccogliere dati reali, imparare dagli errori e trasformare ogni nuova versione di Emma nella base per quella successiva.
E lo stiamo facendo molto velocemente.
Molti se ne sono accorti!
Le risposte di Emma-5, valutate direttamente dagli utenti, hanno restituito, a differenza di quanto emerso sui media, un quadro decisamente più equilibrato: il 39,45% delle risposte è stato valutato positivamente, contro il 60,55% di valutazioni negative. Per un modello di appena 550 milioni di parametri, si è trattato di un primo risultato tutt'altro che negativo.
Abbiamo ricevuto sottoscrizioni, contributi volontari e numerose richieste di accesso e utilizzo delle nostre API. Migliaia di utenti si sono inoltre candidati come Beta Tester ufficiali del progetto Emma.
E la storia e ancora tutta da scrivere...